Cómo usamos RLHF con datos de fabricación
El aprendizaje por refuerzo a partir de retroalimentación humana (RLHF) suele explicarse pensando en un modelo de chat: las personas ordenan respuestas, un modelo de recompensa aprende ese orden y la política se optimiza contra él. El ciclo que operamos sobre planos de ingeniería y ofertas tiene la misma forma, pero casi ninguna de las mismas piezas. Las personas que evalúan son técnicos de ofertas sénior e ingenieros de calidad, y no evaluadores de crowdsourcing. Buena parte de la recompensa es un hecho verificable frente a un BOM liberado o un precio real, más que una preferencia. Y lo que se optimiza, de forma deliberada, es algo distinto del modelo que lee el plano.
Este artículo explica cómo está construido ese ciclo: de dónde viene la retroalimentación, qué recompensa, qué cambia y por qué nunca sale del tenant del cliente.
De dónde viene la retroalimentación
Tres tipos de personas aportan señal al sistema, y cada uno lo hace de manera diferente.
Los primeros son los expertos de dominio que construyen los conjuntos de referencia (golden sets). Un plano se entrega a dos ingenieros de calidad que trabajan por separado; cada uno etiqueta todas las características del plano: tipo, valor y ubicación. En una hoja densa de una pieza fundida son más de doscientos elementos. Donde los dos discrepan, y en un plano real discrepan en aproximadamente uno de cada diez elementos, el desacuerdo se resuelve escribiendo la regla, sin recurrir a un voto de desempate: si una tolerancia de posición con un marco de tres referencias es una característica o tres, si «4X» es una cantidad o forma parte de la identidad de la característica, qué hoja manda sobre una nota que modifica otra hoja. El estándar de etiquetado que resulta de este trabajo es lo primero que las personas le enseñan al sistema, y todo lo que viene después se mide con él.
El segundo es el juez. Comparar la salida de un modelo con el conjunto de referencia va más allá de comparar cadenas de texto; un comparador de cadenas empareja «R71,5» con «R7,5» y lo cuenta como acierto. Por eso, un modelo juez, entrenado con el estándar de etiquetado, decide si dos descripciones corresponden a la misma característica. Cada veredicto se guarda en caché y lleva una razón de una línea. Así la recompensa se puede auditar: cuando una puntuación se mueve, podemos leer por qué.
El tercero, y el que opera de forma continua en producción, es el técnico de ofertas. Cada paquete que procesa el sistema vuelve con una lista de excepciones: las ambigüedades que encontró, cada una con una propuesta de resolución y la evidencia que la respalda. El técnico de ofertas acepta, edita o corrige cada una, y después aprueba o modifica las líneas del BOM y de coste antes de que salga cualquier cosa. Cada una de esas acciones se registra como una preferencia: lo que propuso el sistema, lo que eligió la persona y en qué hoja. Ese registro es el conjunto de datos de RLHF en sentido estricto, y crece con cada oferta.
En qué consiste realmente la recompensa
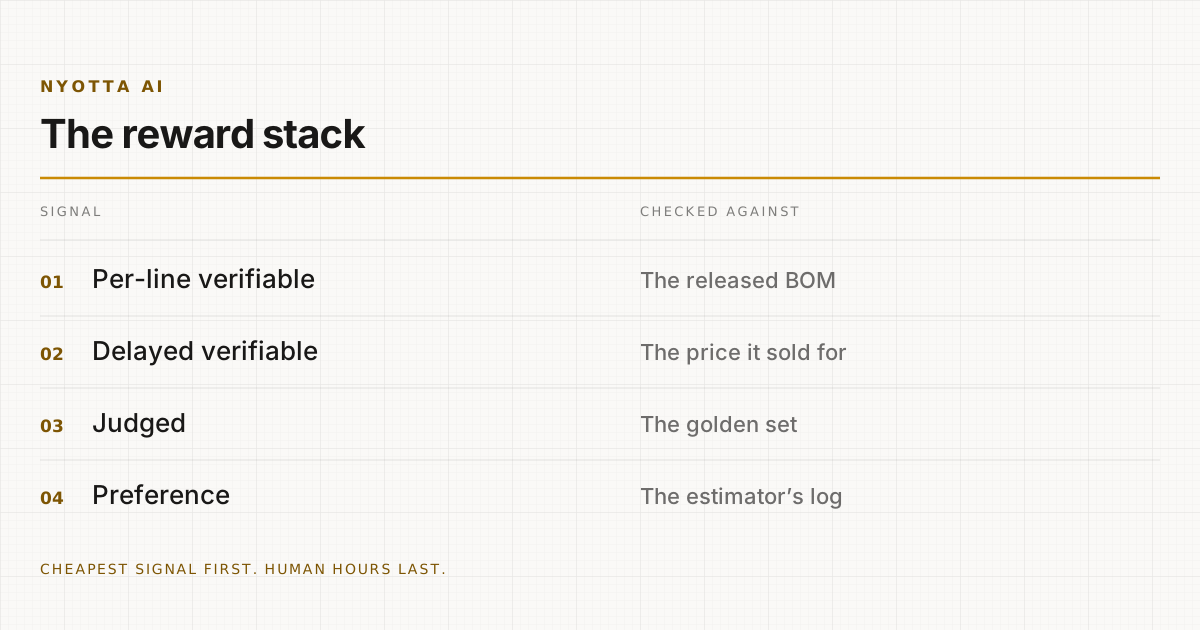
La receta de los modelos de chat usa un solo modelo de recompensa porque no existe una verdad de referencia para «útil». En las ofertas muchas veces sí existe, así que la recompensa se compone de fuentes de distinta naturaleza, y la más cara se usa al final.
Recompensa verificable por línea. Cuando existe un BOM liberado del cliente, cada línea extraída se verifica con él: referencia, cantidad, material, coincidencia exacta. Es la señal más densa y barata del sistema, y no requiere a ninguna persona.
Recompensa verificable diferida. Si el coste objetivo quedó dentro de la tolerancia respecto al precio al que realmente se vendió la pieza. Es escasa, llega meses después, tiene ruido y es la que más le importa al negocio.
Recompensa evaluada por el juez. Para las salidas que no tienen una fila liberada con la que verificarse, el veredicto del juez frente al conjunto de referencia.
Recompensa por preferencia. El registro de aceptaciones y correcciones del técnico de ofertas, que se usa para las decisiones que de verdad requieren criterio. Si la resolución propuesta para un conflicto de revisiones era correcta. Si valía la pena abrir una excepción. Cuál de dos redacciones de la misma ambigüedad resultó más útil.
Ordenarlas así significa que las horas de las personas se invierten solo donde nada más barato puede producir la señal, y eso es lo que hace asumible el ciclo a la escala de un departamento de ofertas, muy lejos del volumen de una granja de etiquetado.
Qué se optimiza
La política que se optimiza es otra que el lector. Los modelos de visión de frontera que transcriben un plano ya están cerca del techo en esa tarea, y nuestras propias mediciones muestran que las mejoras vienen de otros lados. Por eso el lector se mantiene fijo y la recompensa apunta a las partes del sistema donde una mejor política cambia el resultado:
El detector, que decide en qué parte de la hoja están las regiones. Su recompensa es la precisión de extracción por línea más adelante en el proceso, y es la palanca más grande de todo el pipeline.
La política de excepciones, que decide qué marcar y con qué nivel de confianza. Su recompensa sale directamente del registro del técnico de ofertas: las excepciones aceptadas suman, las descartadas restan y las ambigüedades que se pasaron por alto y se detectaron después restan más.
El enrutamiento de modelos, que elige qué modelo lee cada región y a qué coste. Su recompensa es la precisión por dólar, medida sobre los mismos conjuntos de referencia.
La recuperación de precedentes, que decide qué oferta anterior, qué hilo de aclaraciones y qué registro de tarifas mostrar ante un paquete nuevo. Su recompensa depende de si el técnico de ofertas usó lo que se le mostró.
Cada una es una política pequeña con una recompensa densa y en su mayoría verificable, que es justo el escenario donde el aprendizaje por refuerzo justifica su coste. Entrenar un lector grande con una señal de preferencia escasa es el escenario donde no lo justifica, y por eso no lo hacemos.
Por qué se queda en el tenant
En un producto de consumo, todos los evaluadores provienen de la misma población y la política es compartida. En el departamento de ofertas de un proveedor Tier 1, los evaluadores son los técnicos de ofertas de ese proveedor, sus preferencias reflejan sus márgenes y su apetito de riesgo, y los datos están amparados por un acuerdo que prohíbe usarlos para mejorar el producto de cualquier otro.
Por eso el ciclo se divide a lo largo de una línea que, además, resulta ser la línea correcta desde la ingeniería. La percepción se comparte: una indicación de rosca es una indicación de rosca en cualquier proveedor, y las recompensas verificables por leerla se agrupan entre clientes sin llevar nada específico de ninguno. El criterio no se comparte: con qué agresividad marcar, qué precedente de margen aplica, qué historial de aclaraciones importa. La política de excepciones y la de recuperación se entrenan por tenant, con el registro de ese tenant, y en ningún otro lugar.
Esa es la razón por la que el sistema mejora sobre los planos de un proveedor concreto, más que sobre el plano medio del sector. También es la razón por la que vale la pena registrar la corrección de un técnico de ofertas: es el único registro que existe del criterio de ese proveedor, y le pertenece.
Cómo se protege la recompensa
Toda recompensa puede manipularse, y en fabricación las formas de hacerlo son tan concretas que se pueden nombrar; por eso las salvaguardas se construyen antes de la primera actualización de la política, sin esperar al primer incidente.
Si se le recompensa por tener menos líneas equivocadas, un sistema aprende a producir menos líneas; por eso el recall y la precisión se puntúan por separado. Si se le recompensa por excepciones confirmadas, aprende a marcarlo todo; cada excepción abierta tiene un coste, así que marcar tiene precio. Si se le recompensa por la precisión del coste objetivo frente al precio real, aprende a anclarse en la última oferta de la misma pieza; los programas reservados que el sistema nunca ha visto se puntúan por separado, de modo que el anclaje aparece como una caída donde se puede ver.
Nada de esto es novedoso. Todo esto es lo que distingue un ciclo de retroalimentación que mejora un sistema de ofertas de uno que, sin que nadie lo note, le enseña a informar de menos.
Qué significa para el proveedor
Las correcciones de sus técnicos de ofertas son los datos de entrenamiento. Se quedan en su tenant, mejoran el sistema sobre sus planos y sus programas, y no aparecen en el producto de nadie más. Las excepciones que usted descarta le enseñan a dejar de preguntar; las que confirma le enseñan qué importa; el precedente que usa le enseña qué mostrar la próxima vez.
La consecuencia práctica es que la curva de valor del sistema depende de cuánto de su proceso de ofertas pasa por él, sin importar el calendario de lanzamientos del proveedor de software. Eso es lo que conviene preguntarle a cualquier proveedor, incluidos nosotros: qué cambia exactamente la retroalimentación de su equipo y a dónde va.
Pregúntenos qué cambia realmente la retroalimentación de su equipo. .