我们如何把 RLHF 用在制造数据上
提到基于人类反馈的强化学习(RLHF),大家想到的通常是聊天模型:由人给回答排序,奖励模型学会这种排序,再以它为目标优化策略。我们在工程图纸和报价上跑的这套闭环,整体形态与之相同,具体组成却几乎完全不一样。参与反馈的全部是资深估价人员和质量工程师,没有使用众包评分员。奖励大多是可以核对的事实,能对照已发布的 BOM 或实际成交价格来验证,主观偏好只占其中一部分。我们还特意把读图模型本身排除在优化对象之外。
本文介绍这套闭环是怎么搭起来的:反馈从哪里来,奖励什么,改变什么,以及为什么数据始终不出客户的租户。
反馈从哪里来
向系统输入信号的人有三类,方式也各不相同。
第一类是负责构建黄金数据集的领域专家。同一张图纸会分别交给两位质量工程师独立标注,每人都要把图上的每个特性标出来,包括类型、数值和位置。一张密集的铸件图纸,这样的条目就超过两百项。两人的标注难免有分歧,在真实图纸上大约每十项就有一项。分歧的解决办法是把规则明确写下来,不靠第三人投票裁定:带三基准框格的位置度公差算一个特征还是三个;“4X” 是数量,还是特征标识的一部分;一条会影响其他页的注释,归属于哪一页。由此形成的标注标准,是人教给系统的第一课,下游的所有环节都以它为衡量基准。
第二类是评判模型。拿模型输出和黄金数据集做比对,靠字符串匹配解决不了,字符串匹配会把 “R71.5” 和 “R7.5” 配成一对,还判为命中。所以我们用一个按标注标准训练出来的评判模型,来判断两条特征描述是否指同一个特征。每一次判定都会缓存下来,并附一句理由。这样奖励就可以审计:分数一旦变动,我们能直接看到原因。
第三类是估价人员,也是在生产环境中持续运转的一环。系统处理的每个询价包都会附带一份例外清单,列出它发现的各项歧义,每一项都附有处理建议和依据。估价人员逐项接受、修改或推翻,然后在任何内容发出之前,审批或修改 BOM 和成本条目。每一个操作都会作为一条偏好记录下来:系统提出了什么,人最终选了什么,发生在哪一页图纸上。严格意义上的 RLHF 数据集就是这份日志,每做一单报价,它就增长一次。
奖励究竟是什么
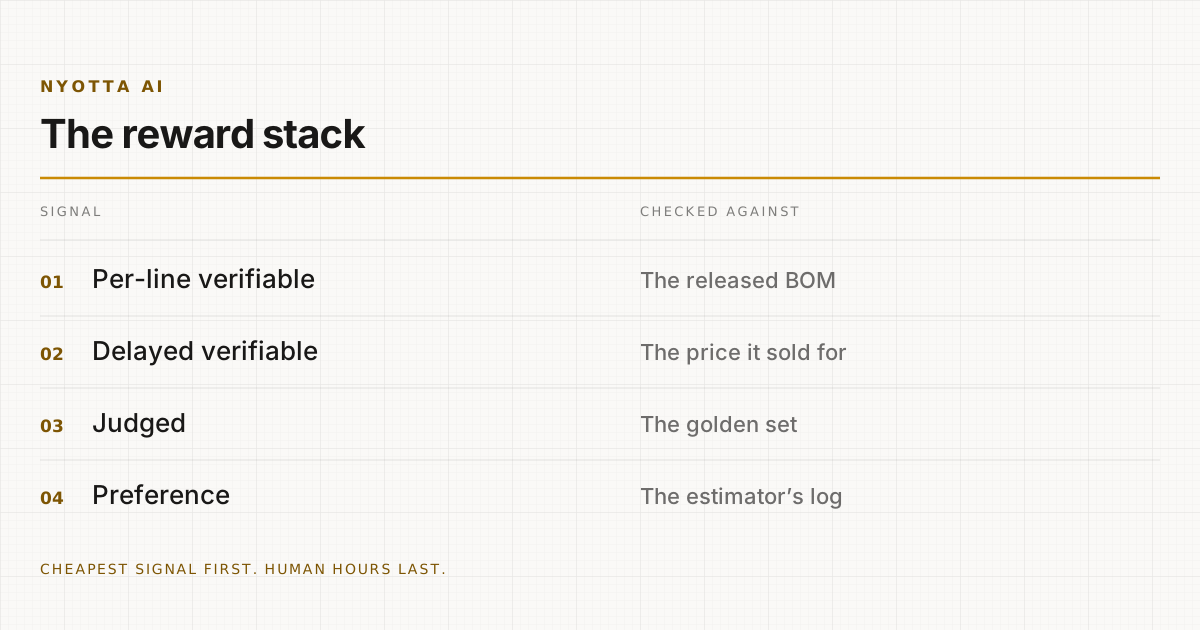
聊天模型只用一个奖励模型,因为“有没有帮助”没有标准答案。报价则往往有标准答案,所以我们的奖励由几类性质不同的来源组合而成,成本最高的那一类放在最后用。
逐行可验证奖励。 客户已有发布的 BOM 时,提取出的每一行都会与之核对,零件号、数量、材料都要完全一致。这是系统里最密集、成本最低的信号,完全不需要人工参与。
延迟可验证奖励。 看应有成本是否落在零件实际成交价格的容差范围内。这类信号稀疏,往往几个月后才到,噪声也大,却是业务上最关心的一项。
评判奖励。 对于没有已发布条目可供核对的输出,以评判模型对照黄金数据集给出的结论作为奖励。
偏好奖励。 来自估价人员的接受与推翻日志,用在真正需要判断的决策上:针对版本冲突提出的处理方式是否正确;某条例外值不值得提出;同一处歧义的两份说明里,哪一份更有用。
按这个顺序排列,人工工时只花在没有更便宜的办法能产生信号的地方。正因如此,这套闭环在一个报价部门的规模上就能负担得起,用不着专门养一支标注团队。
优化的是哪些环节
读图模型不在被优化的策略之列。负责转录图纸的前沿视觉模型在这项任务上已经接近上限,我们自己的测量也显示,提升来自其他环节。所以读图模型保持不变,奖励瞄准的是系统中那些策略一改进、结果就会跟着改变的部分:
检测器,决定图纸上各个区域的位置。它的奖励是下游逐行提取的准确率,也是整条流程中最大的一个杠杆。
例外策略,决定标记哪些内容、以什么置信度标记。它的奖励直接来自估价人员的日志:被接受的例外加分,被驳回的例外扣分,漏掉后来又被发现的歧义扣分更多。
模型路由,决定由哪个模型、以多少成本读取哪个区域。它的奖励是每美元的准确率,在同一套黄金数据集上测量。
先例检索,决定针对新的询价包调出哪一份过往报价、哪一段澄清邮件、哪一条费率记录。它的奖励是估价人员有没有用上调出的内容。
这几个都是小型策略,奖励密集,而且大多可以验证,正是强化学习物有所值的场景。拿稀疏的偏好信号去训练一个大型读图模型,则是得不偿失的场景,所以我们不这样做。
为什么数据留在租户之内
在消费级产品里,所有评分员来自同一个人群,策略也是共享的。到了汽车一级供应商的报价部门,评分员就是这家供应商自己的估价人员,他们的偏好体现的是这家供应商的利润空间和风险偏好,而且数据受协议约束,不得用于改进任何其他方的产品。
所以这套闭环沿着一条界线拆成两部分,这条界线恰好也是工程上合理的分界。感知是共享的:螺纹标注在哪家供应商那里都是螺纹标注,读取它的可验证奖励可以跨客户汇总,且不携带任何客户特有的信息。判断不共享:标记要多激进、适用哪条利润先例、谁的澄清历史更重要,都属于判断。例外策略和检索策略按租户单独训练,只用该租户自己的日志。
正因如此,系统的进步体现在某一家供应商自己的图纸上,与行业平均水平的图纸无关。这也是估价人员每一次推翻都值得记录的原因:这是这家供应商判断力唯一留存的记录,理应归这家供应商所有。
给奖励加上防护
任何奖励都可能被钻空子,而制造场景里的钻空子方式具体到可以逐条列出,所以我们在第一次更新策略之前就把防护建好,不等出了问题再补。
如果奖励的是错误条目更少,系统就会学会少输出条目,因此召回率和精确率分开评分。如果奖励的是被确认的例外,系统就会学会什么都标,因此每提出一条例外都要计入成本,标记是有代价的。如果奖励的是应有成本相对实际成交价的准确度,系统就会学会照搬同一零件上一次的报价,因此系统从未见过的留出项目会单独评分,一旦出现照搬,就会以分数下降的形式清楚地显现出来。
这些做法都谈不上新颖。但一个反馈闭环最终是在改进报价系统,还是在悄悄教它少报,靠的正是这些防护。
这对供应商意味着什么
贵司估价人员的人工修正,就是训练数据。这些数据留在贵司的租户之内,在贵司的图纸和项目上改进系统,不会出现在任何其他方的产品里。被驳回的例外,教会系统不再多问;被确认的例外,教会它什么才重要;被用上的先例,教会它下次该调出什么。
落到实处,系统的价值曲线取决于贵司有多少报价工作经由它完成,供应商的版本发布节奏决定不了它。这也正是该向任何供应商提出的问题,包括向我们:贵司团队的反馈究竟改变了什么,又流向了哪里。
欢迎来问我们:贵司团队的反馈,究竟改变了什么。 。