製造データで RLHF をどう活用しているか
人間のフィードバックによる強化学習(RLHF)は、たいていチャットモデルを例に説明されます。人が回答に順位を付け、報酬モデルがその順位を学習し、その報酬に対して方策を最適化する、という流れです。Nyotta がエンジニアリング図面と見積で回しているループも、全体の形は同じです。ただし、中身はほとんど別物です。フィードバックを与えるのはベテランの積算担当者と品質エンジニアで、クラウドソーシングで集めた評価者は使いません。報酬の多くは人の好みに左右されない事実で、リリース済みの BOM や実際の成約価格と照らし合わせて確かめられます。そして最適化の対象からは、図面を読み取るモデルをあえて外しています。
本稿では、このループの仕組みを紹介します。フィードバックをどこから得ているのか、何に報酬を与えるのか、それによって何が変わるのか、そしてなぜデータが顧客のテナントの外に出ないのか、という 4 点です。
フィードバックの出どころ
システムに信号を与える人は 3 種類で、関わり方もそれぞれ異なります。
1 つ目は、ゴールデンセット(評価用の正解データ)を作る領域の専門家です。1 枚の図面を 2 名の品質エンジニアにそれぞれ独立して渡し、図面上のすべての特性について、種類、値、位置をラベル付けしてもらいます。密度の高い鋳造品の図面なら、200 項目を超えます。実際の図面では、2 名の判断がおよそ 10 項目に 1 項目の割合で分かれます。その場合はどちらかに決めて終わりにせず、判断のルールを書き起こして解決します。たとえば、3 つのデータムを参照する位置度公差は 1 つのフィーチャーか 3 つか。「4X」は数量か、フィーチャーを識別する情報の一部か。別のシートを修正する注記は、どのシートに属するのか。こうしてできたラベリング基準が、人がシステムに最初に教える内容になり、以降のすべての評価はこの基準に沿って行われます。
2 つ目は、判定役となるジャッジです。モデルの出力とゴールデンセットの比較は、文字列の一致では判定できません。文字列で照合すると、「R71.5」と「R7.5」を一致とみなしてしまうからです。そこで、ラベリング基準をもとに学習させたジャッジモデルが、2 つの記述が同じフィーチャーを指しているかどうかを判定します。判定結果はすべてキャッシュされ、1 行の理由が付きます。これで報酬そのものを監査できるようになり、スコアが動いたときにはその理由を読んで確かめられます。
3 つ目は積算担当者で、本番環境で常に機能しているのはこのフィードバックです。システムが処理した引合パッケージには、必ず例外リストが付いて戻ってきます。システムが見つけた曖昧な点を、解決案とその根拠とともに並べたものです。積算担当者は各項目を受け入れるか、編集するか、却下し、社外に出す前に BOM と原価の各行を承認または修正します。こうした操作はすべて、選好データとして記録されます。システムが何を提案し、人が何を選び、それがどのシートでの判断だったか、という記録です。このログが厳密な意味での RLHF データセットで、見積を重ねるたびに増えていきます。
報酬は何で構成されているか
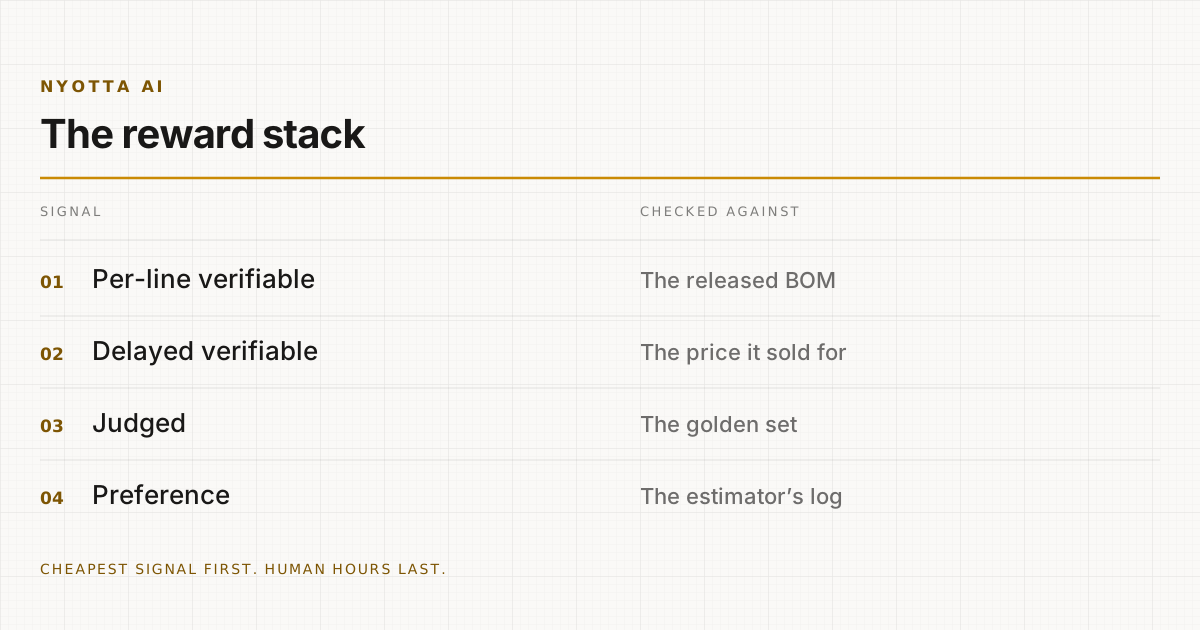
チャットモデルで単一の報酬モデルを使うのは、「役に立つ回答」に正解がないからです。見積業務には正解が存在することが多いため、性質の異なる複数のソースを組み合わせて報酬を構成し、最もコストのかかるソースは最後に使います。
行単位の検証可能な報酬。 顧客のリリース済み BOM がある場合、抽出したすべての行を品番、数量、材料について完全一致で照合します。システムの中で最も密度が高く、最も安価な信号で、人手をまったく必要としません。
時間差で得られる検証可能な報酬。 あるべき原価が、その部品の実際の販売価格に対して許容範囲内に収まったかどうかです。得られる頻度は低く、届くのは数か月後で、ノイズも多い信号ですが、事業にとっては最も重要です。
ジャッジによる報酬。 照合できるリリース済みの行がない出力には、ゴールデンセットに対するジャッジの判定を使います。
選好に基づく報酬。 積算担当者による受け入れと却下のログで、本当に判断が必要な意思決定に使います。改訂版の食い違いに対する解決案は正しかったか。その例外は挙げる価値があったか。同じ曖昧さを説明した 2 つの文面のうち、どちらが役に立ったか。
この順に使うことで、人の工数は、より安価な手段では信号が得られない箇所にだけ費やされます。そのため、このループは大規模なラベリング体制を用意しなくても、見積部門の規模で無理なく運用できます。
何を最適化するのか
最適化の対象に、図面の読み取りモデルは含めていません。図面を書き起こす最先端の視覚モデルは、このタスクではすでに上限に近く、当社の測定でも、改善の余地はほかの部分にあることが分かっています。そこで読み取りモデルは固定し、方策を改善すると結果が変わる部分に報酬を向けています。
検出器は、シート上のどこにどの領域があるかを決めます。報酬は下流での行単位の抽出精度で、パイプライン全体の中で最も効果の大きいレバーです。
例外方策は、何を、どの程度の確信度でフラグ付けするかを決めます。報酬は積算担当者のログから直接得られます。受け入れられた例外は加点、却下された例外は減点、見落として後から見つかった曖昧さはさらに大きく減点されます。
モデルルーティングは、どの領域をどのモデルに、どのコストで読ませるかを選びます。報酬は 1 ドルあたりの精度で、同じゴールデンセットで測定します。
先例検索は、新しい引合パッケージに対して、どの過去見積、どの確認メール、どのレート記録を提示するかを決めます。報酬は、提示した情報を積算担当者が実際に使ったかどうかです。
いずれも小さな方策で、報酬の密度が高く、その大部分を検証できます。強化学習がコストに見合う成果を出せるのは、まさにこうした条件です。疎な選好信号で大規模な読み取りモデルを学習させてもコストに見合わないため、当社はその方法を採っていません。
データをテナント内にとどめる理由
一般消費者向けの製品では、評価者は同じ母集団から集められ、方策は全利用者で共有されます。Tier-1 サプライヤーの見積部門では事情が異なります。評価者はそのサプライヤーの積算担当者で、その選好には自社の利益率やリスク許容度が反映されています。しかもデータは、他社の製品改善に使うことを禁じた契約のもとで扱われます。
そこでループを一本の境界線で分けています。この線は、エンジニアリングの観点から見ても理にかなった分け方です。認識の部分は共有します。ねじの指示はどのサプライヤーの図面でもねじの指示であり、その読み取りに対する検証可能な報酬は、顧客固有の情報を含めることなく、複数の顧客にまたがって集約できます。判断の部分は共有しません。どこまで積極的にフラグを立てるか、どの利益率の前例を当てはめるか、誰との確認履歴を重く見るか、といった判断です。例外方策と検索方策は、テナントごとに、そのテナントのログだけで学習させます。
その結果、システムは業界の平均像に寄せることなく、それぞれのサプライヤー固有の図面に合わせて上達していきます。積算担当者の修正をわざわざ記録する意味もここにあります。修正ログは、そのサプライヤーの判断を記録した唯一の資料であり、そのサプライヤーに帰属するものです。
報酬の悪用を防ぐ仕組み
どの報酬も悪用される可能性があり、製造分野での悪用のパターンは具体的に挙げられます。そのため、最初のインシデントを待たず、最初の方策更新より前に防止策を組み込んでいます。
誤った行が少ないほど報酬を与えると、システムは出力する行そのものを減らすことを覚えます。そこで再現率と適合率を別々に採点しています。承認された例外に報酬を与えると、何でもフラグ付けすることを覚えます。そこで例外を一つ挙げるごとにコストを課し、フラグ付けに代償を持たせています。実際の成約価格に対するあるべき原価の精度に報酬を与えると、同じ部品の前回見積に寄せることを覚えます。そこで、システムが一度も見ていない案件を評価用に取り分けて別に採点し、前回見積への依存がスコアの低下として目に見える形で表れるようにしています。
どれも目新しい手法ではありません。それでも、見積システムを改善するフィードバックループになるか、システムに過少報告をひそかに教え込むループになるかは、こうした仕組みで決まります。
サプライヤーにとっての意味
積算担当者の修正が、そのまま学習データになります。データは自社のテナント内にとどまり、自社の図面と案件でシステムを改善し、他社の製品に使われることはありません。却下した例外は「ここは尋ねなくてよい」ことを、承認した例外は「何が重要か」を、活用した前例は「次回何を提示すべきか」をシステムに教えます。
実務上の帰結として、システムの価値がどこまで伸びるかは、見積業務のどれだけがシステムを通るかによって決まります。ベンダーのリリース予定に左右されるものではありません。当社を含め、どのベンダーにも確認すべきなのはこの点です。自社チームのフィードバックが具体的に何を変え、そのデータがどこへ行くのか。
自社チームのフィードバックで実際に何が変わるのか、お気軽にお尋ねください。 。